

 Directives de soumission d'échantillons
Histogramme de fréquence des caractéristiques original.
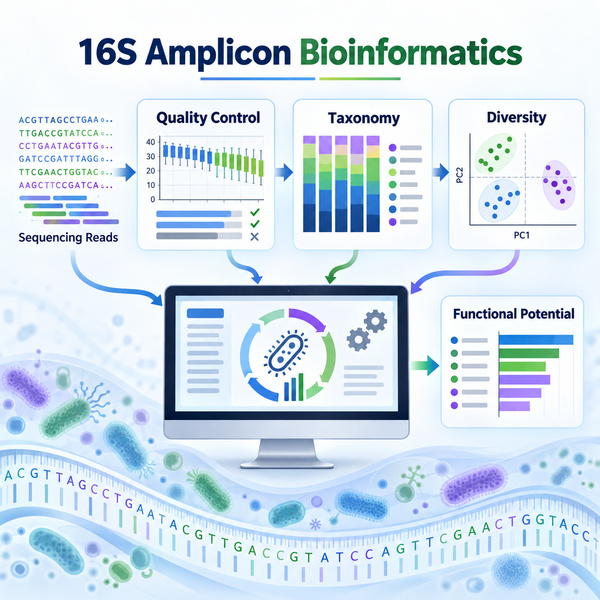
Cet article fournit une brève introduction aux bonnes pratiques pour l'analyse bioinformatique de Séquençage de l'ARNr 16S par NGS (séquençage de nouvelle génération). Le pipeline bioinformatique comprend deux étapes principales : le prétraitement des données (contrôle de qualité) et la quantification (y compris le profilage taxonomique et le profilage métagénomique prédictif).

Figure 1. Pipeline bioinformatique pour le séquençage d'amplicons 16S rRNA basé sur le NGS (Mataragas) et al.. 2018).
Tableau 1. Logiciels et tests statistiques utilisés à chaque étape du pipeline (Mataragas et al.. 2018).
| Étape de pipeline | Test statistique et logiciel utilisé | Logiciel alternatif |
| Traitement | Qiime v.1.9.0 | Pipeline SILVAngs Pipeline BMPOS |
| Profilage taxonomique (OTUs) | Pipeline SILVAngs utilisant la base de données SILVA | Pipeline BMPOS utilisant les bases de données Greengenes Base de données EzBioCloud Pipeline One Codex |
| Comparaison statistique des échantillons métagénomiques | ANOSIM utilisant le logiciel Past | Timbre MicrobiomeAnalyst Explicet |
| Aperçu de la communauté microbienne | Analyse de la communauté Graphique à barres empilées utilisant le logiciel GraphPad Prism | MicrobiomeAnalyst Explicet |
| Signification statistique des OTUs identifiés | METAGENassist | MicrobiomeAnalyst Explicet |
| Relations symbiotiques et antagonistes au sein de la communauté microbienne | Carte thermique utilisant le logiciel METAGENassist | MicrobiomeAnalyst Explicet |
| Profilage métagénomique prédictif (PMP) | Tax4Fun | Picrust Piphillin MicrobiomeAnalyst |
| Analyse statistique des résultats du PMP | Test H de Kruskal-Wallis avec correction de Tuckey-Kramer pour les tests multiples selon Benjamini-Hochberg Taux de fausses découvertes utilisant le logiciel Stamp | MicrobiomeAnalyst |
| Orientation des échantillons métagénomiques des voies KEGG les plus abondantes | Analyse en Composantes Principales (ACP) utilisant le logiciel Past | MicrobiomeAnalyst Timbre |
| Interactions métaboliques au sein de la communauté microbienne | MMinte | - |
- Prétraitement pour éliminer les données non informatives
La suppression des adaptateurs, des amorces PCR et des bases de faible qualité est une étape nécessaire pour le contrôle de la qualité des séquences. De nombreux outils intégrés ont été développés à cet effet. Le ‘Q’ est le score de qualité de sortie pour les plateformes Illumina (Q10 représente 1 erreur attendue pour chaque 10 bases ; Q20 représente 1 erreur attendue pour chaque 100 bases...). L'élimination des séquences avec des scores de qualité faibles peut améliorer l'exactitude des analyses bioinformatiques. Comparé au séquençage shotgun, cela est plus significatif pour le séquençage des amplicons 16S rRNA. Pour le séquençage du gène 16S rRNA, il est supposé de fixer un seuil de qualité aussi élevé que possible et de couper les séquences sur toute leur longueur.
- Classification taxonomique des séquences bactériennes
Avant la classification taxonomique, les gènes 16S rRNA des bactéries sont regroupés selon deux approches principales. L'une consiste à regrouper ces séquences en phylotypes en fonction de leur similarité avec une base de données de référence, l'autre consiste à regrouper les séquences en unités taxonomiques opérationnelles (OTUs) en utilisant un seuil de similarité de 97 %, uniquement en fonction de leur similarité. Les bases de données de référence disponibles pour l'annotation des gènes 16S rRNA incluent la base de données Greengenes, le projet de base de données ribosomique (RDP), SILVA et le projet du microbiome humain (HMP).
- La diversité bêta (β) pour comparer les microbiomes
La diversité bêta (β) mesure la différence dans la composition de la communauté bactérienne pour différents échantillons. Avant de quantifier la diversité β, les comptes de lectures (lectures mappées à chaque taxon) doivent être normalisés pour minimiser la variabilité technique entre les échantillons. Il existe deux procédures de normalisation courantes : la normalisation par la somme totale et la normalisation par le quartile supérieur.
Il existe deux méthodes principales pour quantifier la β diversité : la β diversité phylogénétique qui prend en compte les différences évolutives entre les communautés (comme UniFrac), et les méthodes non phylogénétiques ou basées sur les taxons (comme la dissimilarité de Bray-Curtis). Une fois que les distances ou dissimilarités entre les échantillons ont été déterminées, elles peuvent être ordonnées dans un espace à faible dimension pour mieux illustrer à quel point elles sont étroitement liées les unes aux autres. Les deux outils d'ordination les plus couramment utilisés sont les analyses en coordonnées principales (ACP) et l'échelle multidimensionnelle non métrique (NMDS).

Figure 2. NMDS et PCoA pour la quantification de la diversité bêta (Jovel et al.. 2016).
- Profilage métagénomique prédictif
La table d'abondance des OTU peut être utilisée pour présumer des fonctions métaboliques. C'est un processus pour comprendre le rôle du microbiome sur le métabolisme de l'hôte et les maladies. Il existe actuellement trois outils puissants pour le profilage métagénomique prédictif (PMP) : PICRUSt, Tax4Fun et Piphillin.
Perspectives d'avenir
Séquençage d'amplicons de l'ARNr 16S il est populaire en raison de ses caractéristiques économiques, efficaces en termes de temps et informatives. Mais il est également limité par plusieurs inconvénients. Tout d'abord, le 16S est bien adapté pour plusieurs patients et des études longitudinales, mais il fournit des informations taxonomiques et fonctionnelles limitées. Deuxièmement, l'amplification par PCR de différentes régions du gène 16S rRNA peut générer des résultats discordants non seulement en raison des affinités de liaison distinctes pour les régions conservées flanquantes correspondantes, mais aussi en raison de la résolution de chaque région variable à travers les taxons. Par conséquent, séquençage complet de l'ARNr 16S ou métagénomique par shotgun peut parfois être plus favorable, surtout ce dernier.
Références :
- Mataragas M, Alessandria V, Ferrocino I, et al.Un pipeline de bioinformatique intégrant un profilage métagénomique prédictif pour l'analyse des données de séquençage 16S rDNA/rRNA provenant des aliments. Microbiologie alimentaire, 2018.
- Yang B, Wang Y, Qian P Y. Sensibilité et corrélation des régions hypervariables dans les gènes de l'ARNr 16S dans l'analyse phylogénétique. BMC bioinformatique, 2016, 17(1) : 135.
- Jovel J, Patterson J, Wang W, et al.Caractérisation du microbiome intestinal à l'aide de la métagénomique 16S ou shotgun. Frontières en microbiologie, 2016, 7 : 459.
Sorties bioinformatiques représentatives du 16S
Des résultats déidentifiés sélectionnés provenant de projets indépendants de 16S illustrent des résumés de caractéristiques, de taxonomie, de diversité, d'ordination et de fonction inférée. Les approches d'analyse et les comptes d'échantillons varient d'un rapport à l'autre.
Chaque figure conserve les marques de tracé du rapport source avec des étiquettes de projet et des valeurs précises sélectionnées retenues. Différentes figures peuvent provenir de rapports différents ; aucune n'établit une constatation clinique ou un résultat de performance garanti.
10 sorties · 3 étapes
1
Résumé des fonctionnalités et de la taxonomie
Chaleur de l'abondance au niveau du genre, regroupée par clusters.
Carte thermique taxonomique complète d'un projet différent.
2
Diversité et relations
Courbes de raréfaction des caractéristiques observées originales.
Positions des points et ellipses de PCoA de Bray–Curtis.
Carte thermique de distance d'échantillon 16S en longueur complète originale.
Matrice de corrélation d'abondance absolue-relatif originale.
3
Fonctions statistiques et inférées
Extrait du cladogramme central LEfSe.
Comparaison des fonctions prédites par PICRUSt2 ; les valeurs prédites ne correspondent pas à des gènes ou à une activité mesurée directement.
Comparaison des fonctions écologiques de FAPROTAX ; inférence taxonomique uniquement.
